
🎯 3줄 요약
워드프레스 내부링크 자동화를 위해 n8n 워크플로우를 활용해 보았다. 글이 81편이면 제목+카테고리 전체가 2천 토큰밖에 안 돼서, LLM에 통째로 넘기는 게 더 싸고 정확하다. n8n 12개 노드와 mu-plugin 엔드포인트 3개로 글마다 관련 글 3개와 메타 디스크립션 1개를 채웠다.
블로거에서 워드프레스로 옮기는 건 지난 글에서 끝냈다. 근데 옮기고 나니까 조금 큰 문제가 보이더라 😅
문제는 내부 링크로 연결되었던 81편이 서로 하나도 안 이어져 있었던 것이다.
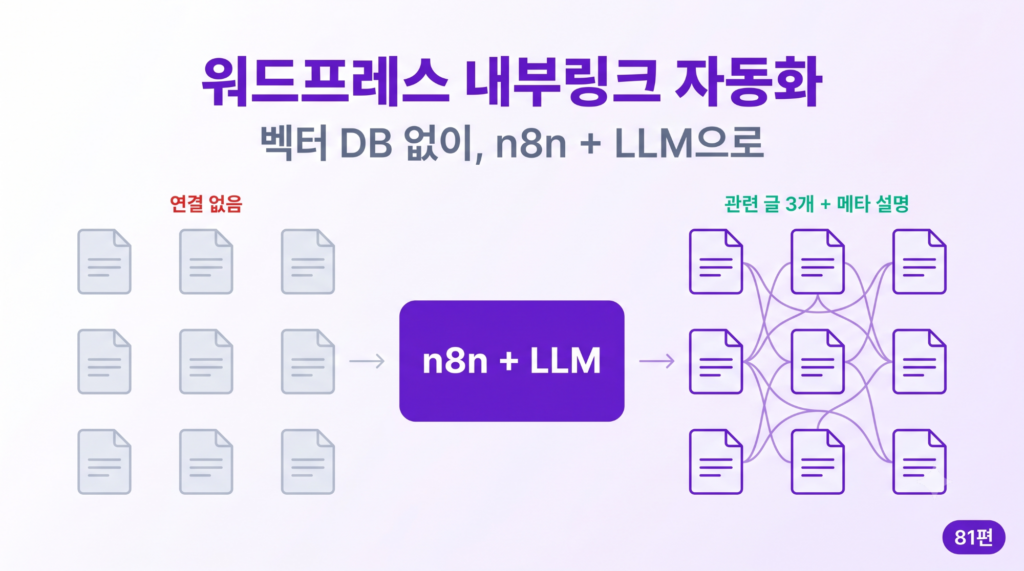
주소가 바뀌면서 예전에 손으로 걸어둔 링크는 다 죽었고, 메타 디스크립션은 절반 넘게 비어 있었다.
검색 결과에 본문 첫 줄이 아무렇게나 잘려 나오고 있고…
손으로 고치면? 81편 × (관련 글 3개 + 설명문 1개). 열심히 해도 며칠짜리였다.
관련 글 플러그인으로는 왜 부족할까?
플러그인은 “내용이 이어지는지”를 안 보기 때문이다.
YARPP 같은 관련 글 플러그인은 카테고리·태그 유사도나 본문 단어 겹침으로 고른다. 그래서 이런 게 나온다.
- ComfyUI 카테고리 글에 → 다른 ComfyUI 글 3개 (다 무관한 모델 이야기)
- 회의록 자동화 글에 → 같은 태그 달린 완전히 다른 프로젝트
내가 원한 건 이거였다. 이 글을 읽은 사람이 다음에 뭘 읽고 싶을까?
선행 지식이 되는 글, 다음 단계를 다룬 글, 같은 문제의 다른 해법.
이건 단순한 유사도가 아니라 본물 글에 대한 판단이라서 LLM 말고는 방법이 없더라.
카페24가 REST 쓰기를 막으면 어떻게 우회할까?
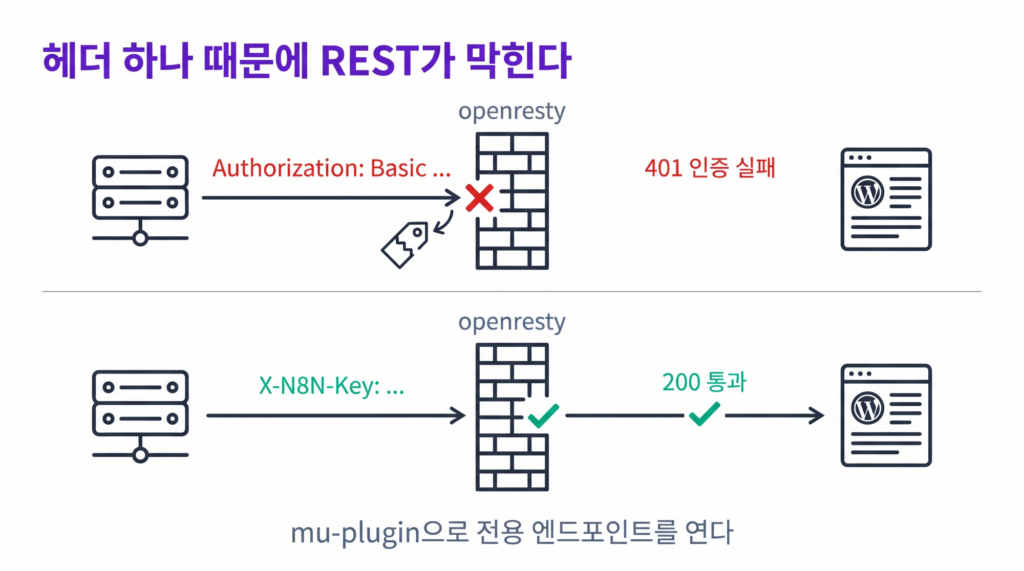
Authorization 헤더를 아예 안 쓰고, 커스텀 헤더로 인증하면 통과한다.
카페24 빌드업 앞단의 openresty가 Authorization 헤더를 벗겨낸다.
그래서 워드프레스 Application Password 인증이 통째로 깨져서 접속이 제대로 안되었다.
이전 작업 때 옵시디언 자동 발행을 포기했던 이유가 정확히 이거였었다.
그래서 mu-plugin을 하나 올려서 전용 엔드포인트 3개를 열고, X-N8N-Key라는 커스텀 헤더로 인증하게 했다.
function n8n_seo_auth(WP_REST_Request $request) {
    $key = $request->get_header('x-n8n-key');
    if (!is_string($key) || $key === '') {
        return new WP_Error('n8n_seo_no_key', 'X-N8N-Key 헤더가 없습니다.', array('status' => 401));
    }
    if (!hash_equals(N8N_SEO_KEY, $key)) {
        return new WP_Error('n8n_seo_bad_key', '키가 일치하지 않습니다.', array('status' => 403));
    }
    return true;
}
되는지 아닌지는 한 줄이면 판정 끝나:
curl -s -H "X-N8N-Key: 발급한키" \
  https://n8n-diy.com/wp-json/n8n-seo/v1/ping
커스텀 헤더는 통과했다. 404면 mu-plugin 경로 문제, 401이면 WAF가 커스텀 헤더까지 벗겨낸 거고, 403이면 키 오타다.
참고로 mu-plugins 폴더는 활성화 절차가 없어서 올리는 즉시 동작한다.
👉 카페24가 아닌 환경이라면 이 섹션은 통째로 필요 없다. 그냥 Application Password 쓰면 된다. 카페24는 보안에 철저하다.
워드프레스 내부링크 자동화에 벡터 DB가 꼭 필요할까?
이 규모에선 아니다. “AI 내부링크 = RAG + 임베딩 + 벡터DB”라는 공식이 워낙 퍼져 있는데, 계산을 한번 해보자.
후보 목록은 이렇게 한 줄씩 만든다.
const candidates = all
  .filter(p => p.id !== t.id)
  .map(p => `${p.id} | ${(p.categories || []).join(',')} | ${p.title}`)
  .join('\n');
81줄. 한 줄에 25~30토큰 잡으면 2천 토큰 남짓이다. 이걸 매번 통째로 프롬프트에 넣어도 아무 문제가 없다. 임베딩 파이프라인 붙이고 Qdrant 띄우고 인덱스 갱신 관리하는 비용이, 절약되는 토큰값보다 압도적으로 크다.
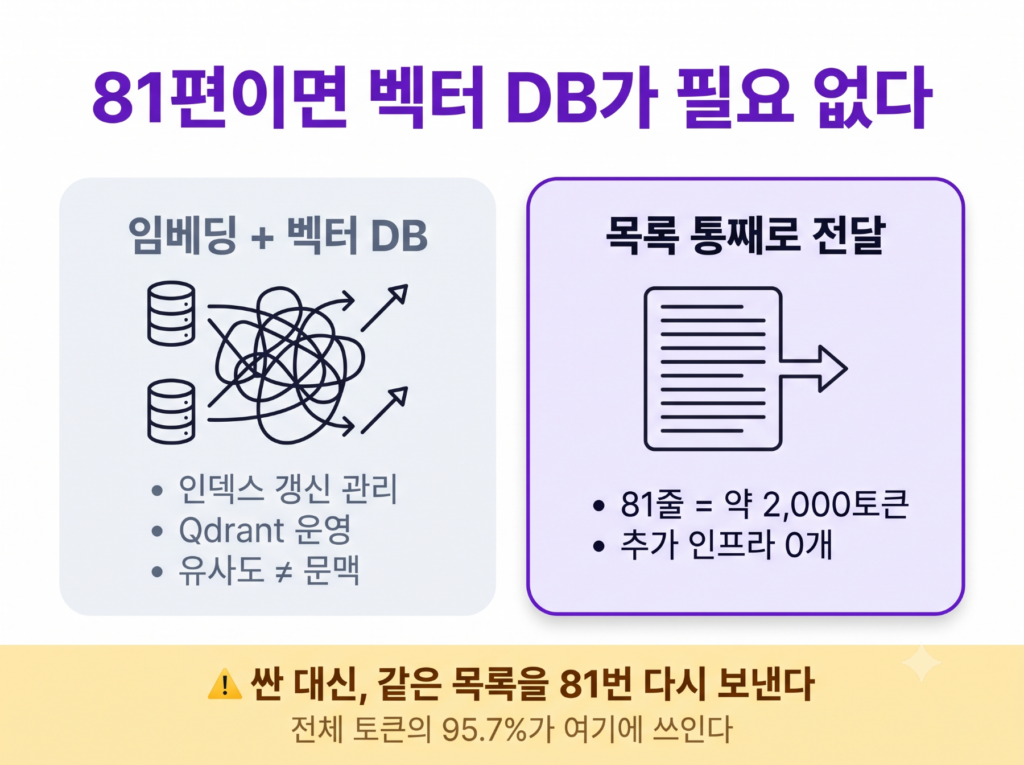
⚠️ 근데 대가도 정확히 찍힌다. 편당 실측 입력 5,981토큰 / 출력 271토큰. 전량 합치면 입력 484,461 · 출력 21,951, 합계 506,412토큰. 입력이 전체의 95.7%, 출력의 22배다. 매번 81편 목록을 다 보내니까 당연한 결과인데, 이 숫자를 숨기고 “벡터 DB 필요 없다”고만 하면 정직하지 않은 글이 된다. 손익분기는 대략 수백 편 단위일 거라고 본다.
본문을 안 건드리고 어떻게 링크를 넣었을까?
포스트 메타에만 저장하고, 출력은 the_content 필터가 맡는다.
81편 본문에 HTML을 자동 주입하는 건 위험 대비 이득이 없다. 잘못되면 복구가 아니라 재작성해야하기 때문이다.
그래서 _n8n_related와 _n8n_metadesc 두 메타 키에만 쓰고, 화면 출력은 필터가 붙인다.
add_filter('the_content', function ($content) {
    if (!is_singular('post') || !in_the_loop() || !is_main_query()) return $content;
    $ids = get_post_meta(get_the_ID(), N8N_SEO_META_RELATED, true);
    if (!is_array($ids) || empty($ids)) return $content;
    // ... <aside> 블록 생성
    return $content . $block;
}, 20);
되돌리기는 두 줄이다. delete_post_meta_by_key('_n8n_related'), delete_post_meta_by_key('_n8n_metadesc'). 아니면 플러그인 파일만 지우면 출력이 사라진다.
대가는 있다. 플러그인 떼면 링크도 같이 사라지는 것이다. 그래도 이 거래가 훨씬 남는 장사다.
프롬프트를 왜 세 번이나 고쳤을까?
여기가 이 글의 진짜 알맹이! 처음부터 잘 된 게 아니라 두 번 실패하고 세 번째에 됐다.
1차 — 160자로 잡았다가 틀렸다
구글 가이드에 흔히 나오는 155~160자를 그대로 썼다. 결과는 전부 잘림. 한글은 픽셀 폭이 넓어서 80자 근처에서 잘린다. 구글은 글자 수가 아니라 픽셀 폭으로 자르기 때문에. 영문 155자 ≈ 한글 75~80자다. 한국어 SEO 글 상당수가 영문 기준을 그대로 옮겨 쓰고 있더라.
2차 — 자르는 걸로는 해결이 안 됐다
기준을 80자로 낮추고 초과분을 잘랐더니, 두 방향 다 나빴어.
| 방식 | 결과 |
|---|---|
| 어절 경계에서 자르기 | …드론·공방 두 조건을 판정하는 대시보드를 하루 만에. → 문장이 끊긴 채 마침표만 붙음 |
| 첫 문장만 남기기 | 97자 → 48자. 문법은 맞는데 최적 길이의 60%만 쓰고 뒷문장 정보가 통째로 날아감 |
3차 — 후보 3개를 받아서 코드가 고르게 했다 ✅
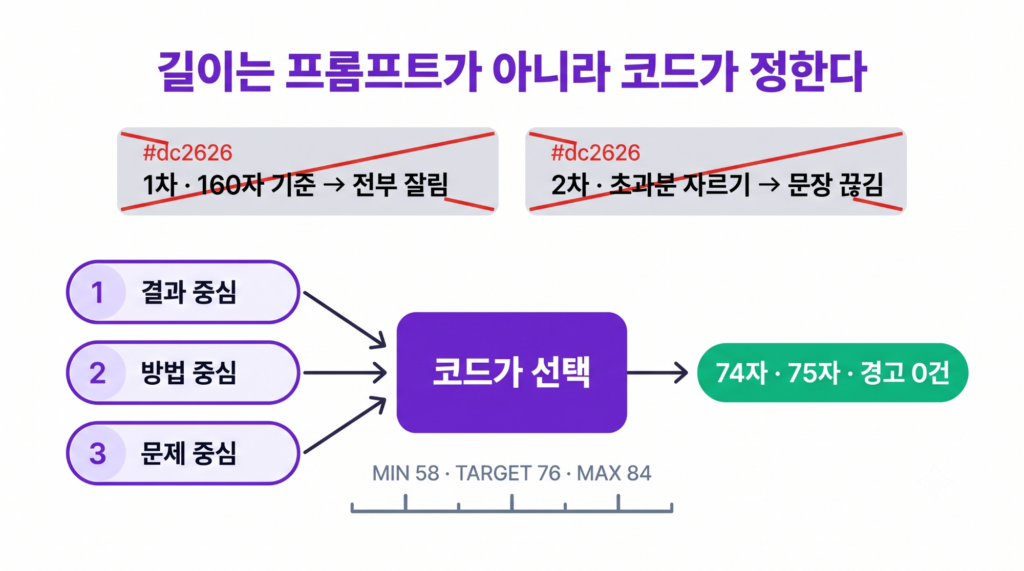
LLM에게 한국어 글자 수를 세라고 하면 계속 빗나간다. 그래서 방향을 바꿨다. 강조점을 나눠 3개를 요청하고, 길이 판정은 코드에 맡긴다.
- 1번: 결과·성과 중심
- 2번: 방법·구성 중심
- 3번: 문제·계기 중심
const TARGET = 76;   // 이상적 길이
const MAX    = 84;   // 이 이상이면 잘라야 함
const MIN    = 58;   // 이 미만이면 자리 낭비

const fit = cands.filter(s => s.length <= MAX);
fit.sort((a, b) => Math.abs(a.length - TARGET) - Math.abs(b.length - TARGET));
실제로 나온 결과 두 개 보여줄게.
대상: PLAUD 대안? 구독료 0원 로컬 AI 회의록, 맥미니로 직접 만들었다
맥미니 한 대에 Whisper, pyannote, 로컬 LLM을 조합해 PLAUD와 동일한 파이프라인을 월 0원으로 구성한 전체 구조 (74자)
대상: data.go.kr API로 나만 쓰는 날씨 판독기 만들기
앱마다 따로 날씨를 확인하는 번거로움을 해결하려고 공공데이터 API를 직접 붙여 드론·공방 두 조건을 동시에 판정하는 도구를 만들었다. (75자)
두 번째는 3번 후보(문제·계기 중심)가 뽑혔다. 제목과 안 겹치면서 검색하는 사람의 상황을 정확히 건드린다. 경고 0건.
💡 일반화 가능한 교훈
모델이 못 하는 제약(정확한 길이)은 프롬프트로 압박하지 말고, 여러 개 받아서 코드로 고르는 게 싸고 확실하다. 토큰 몇백 개 값이다.
모델은 어떤 거짓말을 하고, 코드는 뭘 잡아냈을까?
LLM에 판단을 맡기면 반드시 이런 게 나온다. 전부 응답 검증 노드에서 걸러진다.
- 자기 자신을 관련 글로 선택 — 가장 잦다
- 존재하지 않는 id를 지어냄 (
999같은 거) - 같은 id 중복
- JSON을 코드블록으로 감싸거나 앞뒤에 잡담 붙이기
- 제목을 그대로 되풀이하는 디스크립션 — 제목 어절의 60% 이상이 재등장하면 경고
if (id === src.post_id)   { warnings.push('자기 자신 선택 → 제외'); continue; }
if (!validIds.has(id))    { warnings.push(`존재하지 않는 id ${id} → 제외`); continue; }
그리고 프롬프트에 이 한 줄을 넣은 게 결정적이었다. “같은 카테고리라는 이유만으로 고르지 말 것. 억지로 3개를 채우지 말 것.” 실제로 고른 걸 보면 성격이 다 달라 — 선행 지식 / 같은 접근법의 다른 사례 / 다음 단계.

실제로 81편을 돌린 결과는?
⬜ 발행 전 반드시 채울 것 — 결과 요약 노드 출력에서 그대로 옮겨오기. 처리편수 / 경고있음 / 수동검토필요 / 관련글없음 / 기존설명보존 / 평균디스크립션길이 / 후보선택분포 / 전체 실행 시간 / 실제 비용(USD·원). 후보선택분포가 특히 중요 — 1·2·3번이 고르게 뽑혔으면 강조점 분리가 작동한 것이고, 1번만 쏠렸으면 프롬프트가 결과 중심으로 치우친 것.
다만 확실한 게 하나 있다. 관련 글 0개로 남은 글은 버그가 아니라 발견이다. 어디에도 연결되지 않는 고아 글이 뭔지 알려준 것이다. SEO 보강하려다 사이트 구조 진단이 부산물로 나온 셈이라고 본다.
돌리면서 빠졌던 함정들
- Rank Math 덮어쓰기 사고 직전 —
/ping응답에서 Rank Math가 깔려 있는 걸 발견했다. 초기 코드는rank_math_description에 무조건 덮어썼는데, 그럼 손으로 써둔 설명이 다 날아간다.desc_manual판정을 넣어서 사람이 쓴 건 보존하고 관련 글만 채우게 바꿨다. - 재임포트하면 dryRun이 되돌아간다 😱 — 워크플로 고칠 때마다 파일을 다시 임포트했더니
dryRun이 파일 기본값true로 리셋됐다. “실행은 되는데 반영이 안 되는” 상태의 정체가 이거. n8n의 Import from File은 덮어쓰기가 아니라 새 워크플로 생성이다. - 반영 확인은 화면 말고 API로 — Rank Math 패널은 “Edit Snippet”을 눌러야 실제 저장값이 보여. 그 전엔 자동 생성 미리보기만 나와서 비어 보인다.
/index엔드포인트로 DB를 직접 조회하는 게 캐시·UI와 무관하게 확실하다.
다음엔 뭘 고쳐야 할까?
응답 헤더를 열어보니 이게 찍혀 있었다.
"cache_creation_input_tokens": 0,
"cache_read_input_tokens": 0
프롬프트 캐싱이 81번 내내 한 번도 안 걸렸다. 후보 목록은 거의 같은데도. 원인은 두 개고 둘 다 내 프롬프트 설계 실수야.
- 변하는 부분(대상 글 정보)이 고정 부분(후보 목록)보다 앞에 있다. 캐싱은 prefix가 일치해야 걸리는데 첫 글자부터 달라지니 무효
- 후보 목록에서 자기 자신을 필터링해서 81번이 다 미묘하게 다르다
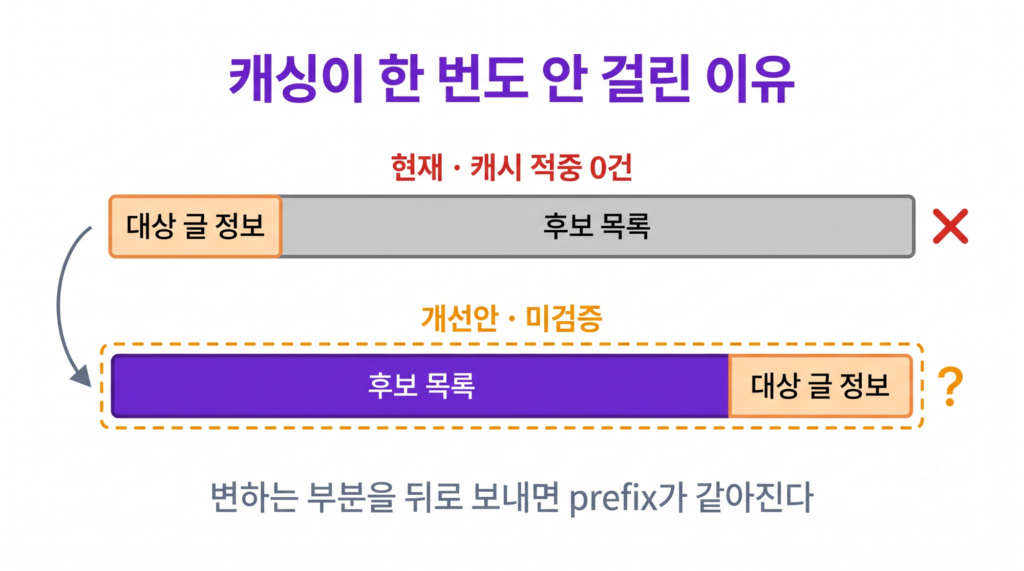
해법은 명확해 보여. 지시문 + 전체 목록(자기 자신 포함)을 앞에 두고, “id ○○은 대상 글이니 제외”라는 한 줄과 대상 글 정보를 뒤로 빼면 prefix가 완전히 같아진다.
다만 이건 아직 적용도 검증도 안 했어. 순서를 바꾸면 선정 품질이 달라질 수 있어서 재검증이 필요한데, 전량 실행은 이미 끝난 상태였기 때문이다. 결과를 확인하지 않은 최적화를 성과처럼 쓰고 싶진 않다. 다음 실행에서 시험해볼 개선점으로 남겨두기로 했다.
운영은 이렇게 갈 생각이다. 주 1회 자동(새 글만) + 분기 1회 수동 전체 재검토. 전체를 자동화하지 않는 이유는, 옛 글이 새 글을 발견하는 건 전체 재검토 때뿐인데 그건 눈으로 봐야 하기 때문이다.
그래서, 해볼 만할까?
워드프레스 내부링크 자동화는 생각보다 문턱이 낮았다. 벡터 DB도, RAG 파이프라인도, 유료 SEO 플러그인도 안 필요했다. 필요한 건 mu-plugin 하나, n8n 노드 12개, 그리고 프롬프트를 세 번 고칠 인내심이었다.
글이 50편쯤 쌓였는데 서로 안 이어져 있다면, 오늘 /ping부터 찍어보길. 거기서 401이 뜨는지 200이 뜨는지가 이 작업 전체의 난이도를 결정할 것이다 🚀
자주 묻는 질문 (FAQ)
Q. 글이 300편이 넘어도 벡터 DB 없이 되나요?
A. 그 규모부턴 다시 계산해야 합니다. 81편에서 편당 입력이 5,981토큰이었으니 300편이면 2만 토큰을 넘어갑니다. 이때부터는 1차 후보를 임베딩으로 30개쯤 좁힌 뒤 LLM에 넘기는 하이브리드가 합리적입니다.
Q. 메타 디스크립션 한글 권장 길이는 몇 자인가요?
A. 70~80자입니다. 구글은 글자 수가 아니라 픽셀 폭으로 자르기 때문에, 영문 기준 155자를 한글에 그대로 적용하면 절반이 잘립니다. 목표 76자, 상한 84자로 잡으면 안전합니다.
Q. 본문에 직접 링크를 넣는 것과 뭐가 다른가요?
A. 되돌릴 수 있느냐가 다릅니다. 포스트 메타 + the_content 필터 방식은 메타 키 두 개를 지우면 원상복구됩니다. 본문 자동 주입은 잘못되면 복구가 아니라 재작성입니다.
Q. Rank Math에 이미 써둔 설명이 날아가지 않나요?
A. desc_manual 판정으로 막았습니다. SEO 플러그인 필드 값이 자동 생성분과 다르면 사람이 쓴 것으로 보고 보존하며, 관련 글만 채웁니다.
Q. 카페24가 아닌 호스팅에서도 mu-plugin이 필요한가요?
A. 아닙니다. Authorization 헤더가 정상 통과하는 환경이면 워드프레스 기본 REST API와 Application Password로 충분합니다. mu-plugin은 헤더 스트리핑 우회용입니다.